今日、AI部下が書いてきた記事を読んでいて、途中で手が止まりました。この話、前にも読んだ気がする。
調べたら、ほぼ同じ内容の記事を、4週間前に公開していました。同じ出来事、同じ結論、同じたとえ話。危うく、自分のブログに自分の記事の競争相手を1本増やすところでした。
先に結論を書きます。記事が増えるほど、書いた本人も、手伝うAIも、「その話はもう書いた」を覚えていられません。だから記事の在庫表を1枚持って、書く前に1コマンドで引く。今日はその作り方と、重複が見つかったときの直し方を置いておきます。
何が起きたか:同じネタで、2本目を書きかけた
今日の動画のネタは、8月に起きた「AI部下が同じ動画を3本アップした」という事件でした。動画を作り、その流れでブログ記事も1本書きました。挿絵も4枚生成し、下書きまで入れて、いよいよ公開という段階です。
そこで気づきました。8月21日に、まったく同じ出来事で記事を出していたのです。
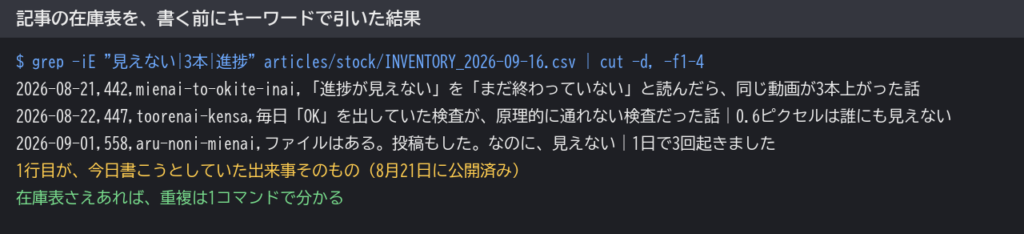
結論の言い回しまで同じでした。「進捗が見えない」と「終わっていない」は別の話。30秒の確認を惜しんだ。速い回線は失敗も加速する。4週間前の自分が、すでに全部書いていました。
なぜ気づけなかったのか
理由は3つありました。どれも、ブログを続けていれば誰にでも起きる話です。
- ネタ帳と記事の在庫が、つながっていなかった——ネタ帳には「この出来事」が書いてあるだけで、それを記事にしたかどうかは書いていませんでした。ネタ帳に残っている=まだ書いていない、と読んでしまった
- 動画で使ったから、ブログでも新作だと思い込んだ——媒体が違えば新作だ、という勘違いです。実際は、動画とブログで同じ出来事を扱っても、ブログ同士が競合します
- 記事が88本になっていた——20本の頃は全部覚えていました。80本を超えると、自分が何を書いたかは記憶では追えません
AIに手伝ってもらっていると、この3つ目が効いてきます。書く速さだけが上がって、覚えておく力は増えないからです。書いた本人が覚えていないものを、AIが覚えているはずもありません。
対策1:記事の在庫表を1枚持つ
うちでは、公開済みの記事を1行1本で並べた表を持っています。中身はこれだけです。
| 列 | 入れるもの |
|---|---|
| date | 公開日 |
| id | 記事の番号(WordPressの投稿ID) |
| slug | URLの末尾 |
| title | タイトル(全文) |
ExcelでもGoogleスプレッドシートでも構いません。大事なのはタイトルを省略せずに入れることです。今回の検索が当たったのは、タイトルの中の「見えない」「3本」でした。スラッグ(英数字のURL)だけの表では引っかかりません。
対策2:書く前に、1コマンドで引く
表を作っただけでは見ません。見る手順を短くします。うちは、キーワードを並べるだけの小さな道具を作りました。
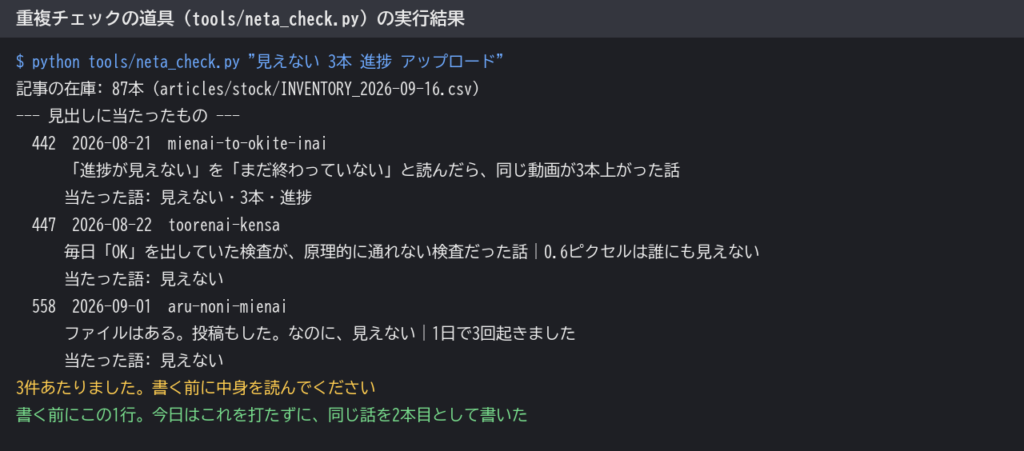
# tools/neta_check.py — 書く前に「もう書いていないか」を在庫表で引く
import csv, glob, io, sys
rows = list(csv.DictReader(io.open(sorted(glob.glob("articles/stock/INVENTORY_*.csv"))[-1], encoding="utf-8")))
words = [w for a in sys.argv[1:] for w in a.split()]
for r in rows:
    hay = r["title"] + " " + r["slug"]
    hit = [w for w in words if w in hay]
    if hit:
        print(r["id"], r["date"], r["slug"])
        print("   ", r["title"])
print(" 当たった語:", "・".join(hit))コマンドを使わない場合は、スプレッドシートの検索(Ctrl+F)でも同じことができます。1語でも当たったら中身を読む。これだけで、今日の失敗は防げました。
引く言葉は、記事の中心にある名詞を3〜5個です。今日なら「見えない」「3本」「進捗」「アップロード」。タイトル案をそのまま入れても構いません。
対策3:ネタ帳に「どこで使ったか」を書く
在庫表と対になるのが、ネタ帳の側です。うちのネタ帳は、実務で起きた出来事を1行ずつためたものですが、今日から各行の末尾にこう書くことにしました。
㉚ 同じ動画が3本上がっていた
→ 【記事化済み】ブログ442(8/21)/動画Vol10(9/18)/note57(9/18)ポイントは、媒体ごとに分けて書くことです。「動画で使った」と「ブログで書いた」はまったく別の話で、混ぜると今日と同じ間違いが起きます。
重複が見つかったら、どうするか
今日の私がやったのは、次の形です。新しい記事は出さず、古い記事を厚くしました。
- 新しい記事は公開しない——下書きのまま保管し、先頭に「この記事は◯◯と重複」とメモを残す
- 新しく用意した素材だけを、古い記事に足す——今回は、実際の画面の画像2枚、動画へのリンク、その後に道具へ入れた対策のコード
- 記事末に「最終更新」を書く——いつ、何を足したかを1行で
同じ検索意図の記事が2本あると、検索エンジンからはどちらを出すべきか分かりません。共倒れになるくらいなら、1本を厚くしたほうが読者にも親切です。8月の記事は、今日の追記で7,700字から9,000字近くになりました。
なお、媒体が違えば重複にはなりません。今日のエッセイ(note)はそのまま公開しました。同じ出来事でも、ブログは手順、noteは気持ち、動画は掛け合いと、役割が分かれているからです。この分け方は「ブログとnoteはどう使い分ける?重複コンテンツを避ける役割分担のルール」に詳しく書いています。
よくある質問
古い記事を消して、新しい記事を出すのではだめですか?
おすすめしません。公開から時間が経った記事は、検索エンジンに評価が積み上がっています。消すとそれを捨てることになります。新しく書いた文章のほうが良いと思うなら、その文章で古い記事を書き換えるのが順当です。
AIに「前に書いた記事を覚えておいて」と頼めばいいのでは?
会話が変わると忘れます。覚えていてほしいことは、AIの記憶ではなくファイルに置くのが確実です。今回で言えば在庫表がそれにあたります。AIは毎回それを読みに行けば済みます。
在庫表は、どうやって作りますか?
WordPressなら、管理画面の投稿一覧をコピーして貼るだけでも作れます。うちはREST APIで書き出していますが、手で作った表でも役目は同じです。月に1回、新しく公開した記事を足すだけで維持できます。
まとめ|覚えている、を前提にしない
- 4週間前に書いた記事と同じ内容で、2本目を書きかけた。公開直前に気づいた
- 原因は、ネタ帳に「記事化済み」が書いていなかったこと、媒体が違えば新作だと思ったこと、記事が88本になって記憶で追えなくなったこと
- 対策は、タイトル全文を入れた在庫表を1枚持ち、書く前にキーワードで引くこと
- ネタ帳の各行には「どこで使ったか」を媒体ごとに書く
- 重複が見つかったら、新記事を出さず、素材だけ古い記事に足して「最終更新」を書く
記事が増えるのは良いことですが、増えた分だけ「自分が何を書いたか」は曖昧になります。今日の1コマンドは、そのための保険でした。