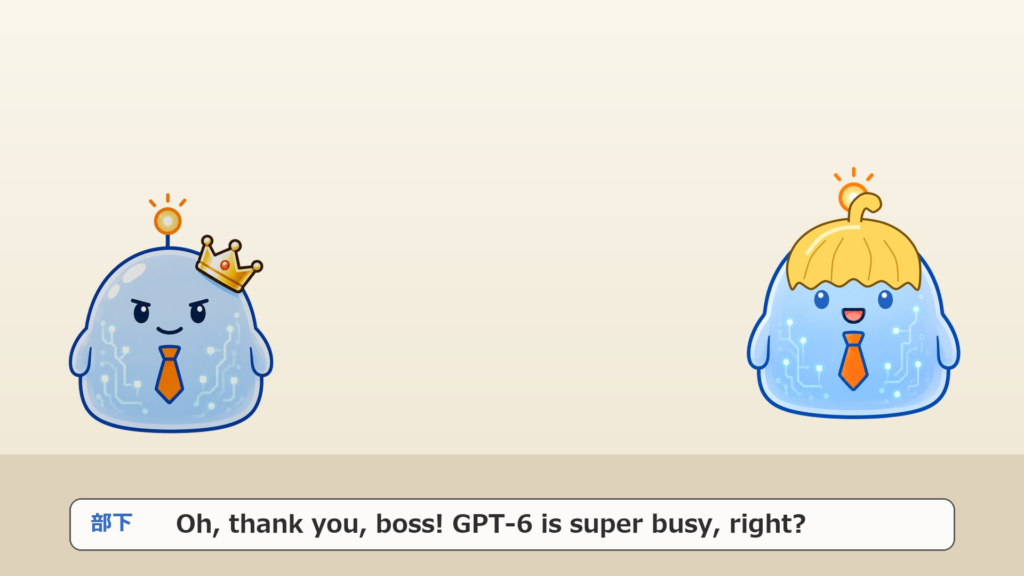
AI部下を「GPT-6が大盛況らしいな。お前も頑張れよ?」とあおったら、返事が急に全文英語になりました。怒ったのかと聞いたら、怒ってはいない、なぜ英語になったのかは自分でも説明できない、という返事でした。面白かったので、うちのYouTubeでこの話を動画にしました。
困ったのは、動画の声です。部下の声はVOICEVOXで作っています。英語をしゃべらせたい。でも、それっぽく聞こえないと笑えません。
先に結論を書きます。カタカナに「強く読む音」の印を付けて渡すと、えせ英語が一気に英語っぽくなります。印の書き方には、エラーになる決まりが4つありました。今日は、4通り試した長さの比較と、実際に踏んだエラーの画面、そのまま使えるコードを置いておきます。
英文をそのまま渡すと、読める。ただし誤読する
まず、何も工夫せずに英文を渡してみました。使ったのはVOICEVOX 0.25.2のエンジンです。意外なことに、英文もカタカナに直して読んでくれます。
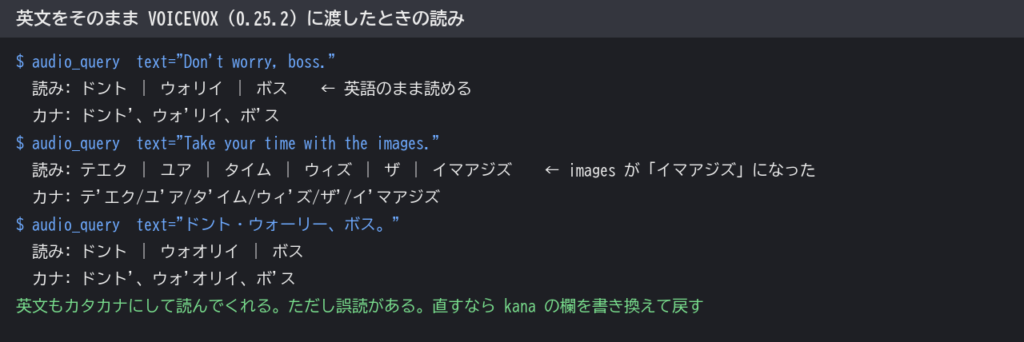
「Don’t worry, boss.」は問題なし。ところが「images」は「イマアジズ」になりました。なぜこう読むのかは分かりません。英語のまま渡すと、どこで読み違えるかは鳴らしてみるまで分からない、ということです。
ここで大事な発見がありました。VOICEVOXに読みを問い合わせると、返ってくるデータの中に kana という欄があります。中身は テ'エク/ユ'ア/タ'イム/ウィ'ズ/ザ'/イ'マアジズ。エンジン自身が、読みと強く読む位置をこの記法で持っているんです。なら、この記法で書いて渡せば、読みも強さもこちらで決められます。
4通り試して、長さを測った
同じ英文3行(「Oh, don’t worry, boss.」など)を、読ませ方を変えて4本書き出しました。声は部下役の白上虎太郎です。
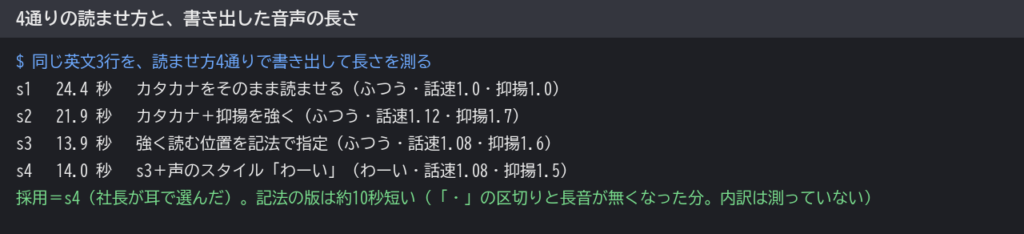
| 版 | 渡し方 | 聞いた印象 |
|---|---|---|
| s1 | 「ドント・ウォーリー、ボス」をそのまま | 日本人が教科書を読んでいる。平ら |
| s2 | s1の抑揚を1.7倍・少し速く高く | ノリは出るが、強くなる場所がずれる |
| s3 | 強く読む位置を記法で指定 | 英語のリズムに近づく |
| s4 | s3を同じ声の「わーい」スタイルで | 陽気なアメリカ人っぽい。採用 |
選んだのは社長の耳です。記法の版はどちらも約10秒短くなりました。「・」の区切りと長音が無くなった分ですが、どれがどれだけ効いたかの内訳は測っていません。
やり方:「強く読む音」の後ろに ‘ を書く
記法の決まりは3つだけです。
- ‘(アポストロフィ)——その直前の音を強く読む。「ドン’ト」なら「ン」まで高く、「ト」で下がる
- /(スラッシュ)——言葉の区切り。区切りごとに強い音が1つ
- 、(読点)——少し間を空ける
英語で強く言う場所に ‘ を置けば、それっぽくなります。「Don’t worry, boss.」なら ドン'ト/ウォ'ウリイ、ボ'ス です。
VOICEVOXのエンジンが起動していれば、このPythonで鳴らせます。文ごとに分けて作り、短い間でつなぎます。
# eigo_voice.py — 記法で書いたカタカナ英語を VOICEVOX で wav にする
import json, urllib.request, urllib.parse, wave, io
API, SPEAKER = "http://localhost:50021", 32   # 32 = 白上虎太郎「わーい」
def post(path, params, body=None):
    url = f"{API}{path}?{urllib.parse.urlencode(params)}"
    data = json.dumps(body).encode() if body is not None else b""
    req = urllib.request.Request(url, data=data, method="POST", headers={"Content-Type": "application/json"})
    return urllib.request.urlopen(req).read()
def say(kana):
    q = json.loads(post("/audio_query", {"text": "あ", "speaker": SPEAKER}))      # 設定の入れ物だけ借りる
    q["accent_phrases"] = json.loads(post("/accent_phrases", {"text": kana, "speaker": SPEAKER, "is_kana": "true"}))
    q.update(speedScale=1.08, intonationScale=1.5)
    return post("/synthesis", {"speaker": SPEAKER}, q)
sentences = ["オ'ウ、ドン'ト/ウォ'ウリイ、ボ'ス", "ホエ'ン/イ'ッツ/ビ'ジイ、ア'イ/キャ'ン/ビ'イ/ス'ロウ/トゥ'ウ"]
clips = [wave.open(io.BytesIO(say(s))) for s in sentences]
with wave.open("eigo.wav", "wb") as out:
    out.setparams(clips[0].getparams())
    gap = b"\x00" * int(clips[0].getframerate() * 0.12) * 2       # 文と文の間 0.12秒
    out.writeframes(gap.join(c.readframes(c.getnframes()) for c in clips))
ポイントは is_kana=true です。これを付けると、VOICEVOXは漢字の読みを推測せず、渡した記法をそのまま使います。
踏んだエラー4つ
書き始めてすぐ、エラーが続きました。どれも「400 Bad Request」だけでは原因が分からず、返ってきた本文を読んで分かったものです。
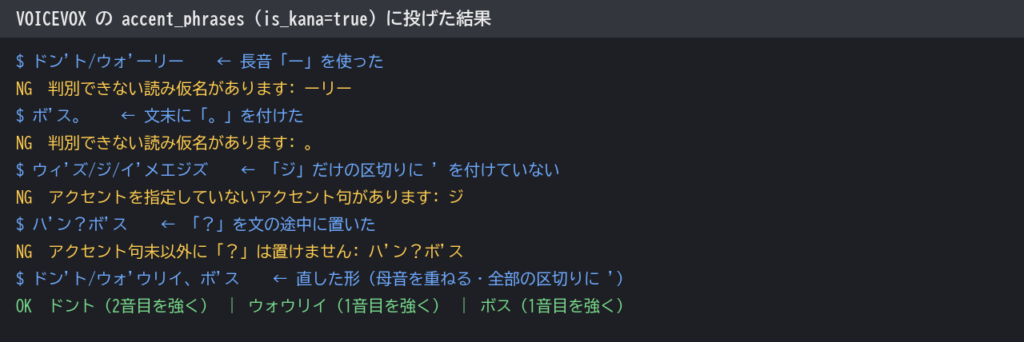
- 長音「ー」は使えない——「ウォ’ーリー」はエラー。母音を重ねて「ウォ’ウリイ」と書く。エンジン自身も kana 欄で「ウォ’オリイ」と重ねていました
- 「。」は使えない——文の終わりは何も付けない。文を分けたいときは、別々に作ってつなぐ
- 区切りごとに ‘ が必ず要る——「ウィ’ズ/ジ/イ’メエジズ」は「ジ」に印がなくてエラー。1音だけの言葉は前とくっつけて「ウィ’ズジ」にする
- 「?」は区切りの最後だけ——「ハ’ン?ボ’ス」はエラー。「ハ’ン?」で1文として分ける。文末の?は語尾が上がるので、疑問文らしくなります
エラーの本文は {"detail":{"text":"判別できない読み仮名があります: ーリー"}} のように日本語で理由が書いてあります。エラーが出たら、まず本文を表示するようにしておくと早いです。
ボスの「おい」3段は、音量と高さで上げる
動画では、英語をしゃべり続ける部下に、ボスが「おい」「おい!」「おい!!」と3回ツッコみます。同じ声で怒りが上がって聞こえるよう、1段ごとに数字を上げました。声はボス役の剣崎雌雄です。
| セリフ | 音量(volumeScale) | 高さ(pitchScale) | 抑揚(intonationScale) |
|---|---|---|---|
| おい | 1.0 | 0 | 1.0 |
| おい! | 1.45 | 0.04 | 1.3 |
| おい!! | 1.9 | 0.09 | 1.6 |
音量だけでなく、高さと抑揚も一緒に上げたのは、声を張った感じを出したかったからです。3段とも1回で社長の検収を通りました。
字幕は英文だけにした
英語のセリフには、和訳を付けませんでした。ボスと一緒に、見ている人にも「???」となってもらうためです(社長の指定)。中身はとても親切なことを言っているのに、言葉が違うだけで伝わらない。そこがこの話の面白いところなので、訳すと消えてしまいます。
ひとつだけ直した点があります。縦長のショート動画では字幕の幅が狭く、「images」が「im」と「ages」に割れて折り返されました。日本語用の折り返しは1文字ずつ区切るので、英単語の途中では折らず、空白まで戻して折るように変えました。英文の字幕を焼き込むときは、ここを確認しておくと安心です。
おまけ:AIの返事が急に英語になったら
動画のもとになった出来事の直し方も書いておきます。同じ日に3回起きました(全文が英語/次の返事の最初の1文だけ英語/動画の案を出した直後の1文だけ英語)。
- 「日本語で」と一言返す——うちはこれで戻りました
- いつも読ませる指示に「返事は日本語」と書いておく——うちはまだ試していません。次に起きたとき、これで出なくなるかを確かめます
- 怒っているわけではない——理由はAI自身にも説明できませんでした。中身はいつもどおり親切だったので、言葉だけ戻してもらえば十分です
まとめ|英語っぽさは、発音より「強く読む場所」
- VOICEVOX 0.25.2は英文もカタカナにして読むが、「images→イマアジズ」のような誤読がある
- 読み問い合わせの
kana欄にある記法で書いてis_kana=trueで渡すと、読みと強さをこちらで決められる - 4通り試した結果、強く読む位置を指定+「わーい」スタイルが一番それっぽかった
- 記法のエラーは4つ:「ー」不可・「。」不可・区切りごとに ‘ 必須・「?」は区切りの最後だけ
- ツッコミの3段は、音量と一緒に高さと抑揚も上げた(1.0/1.45/1.9)
英語が得意でなくても、「どこを強く言うか」だけ決めれば、声はそれっぽくなりました。完成した動画は、YouTube「うちのAI部下」の「あおったら、急に英語で返事してくるAI」です → https://youtu.be/2AZrpFcSNzk